自从 Deep Blue 在 1997 年击败国际象棋世界冠军加里·卡斯帕罗夫,到 AlphaGo 在 2016 年战胜围棋传奇李世石,人工智能在完全信息博弈领域取得了里程碑式的成就。然而,一款名为《战棋》(#Stratego)的经典策略游戏,却长期以来让AI望尘莫及。即使是拥有雄厚财力的 DeepMind,也未能研发出能稳定击败顶尖人类玩家的机器。
如今,这一僵局已被打破。由卡内基梅隆大学、麻省理工学院、纽约大学和斯坦福大学的联合研究团队,成功打造出名为 Ataraxos 的AI系统。这款AI在与被誉为史上最强《战棋》玩家 Pim Niemeijer 的对决中,以 15 胜 1 负 4 平 的压倒性战绩获胜。更令人惊叹的是,Ataraxos 的训练成本仅需 16 块 GPU 和数千美元,这与其达成的成就形成了鲜明对比。
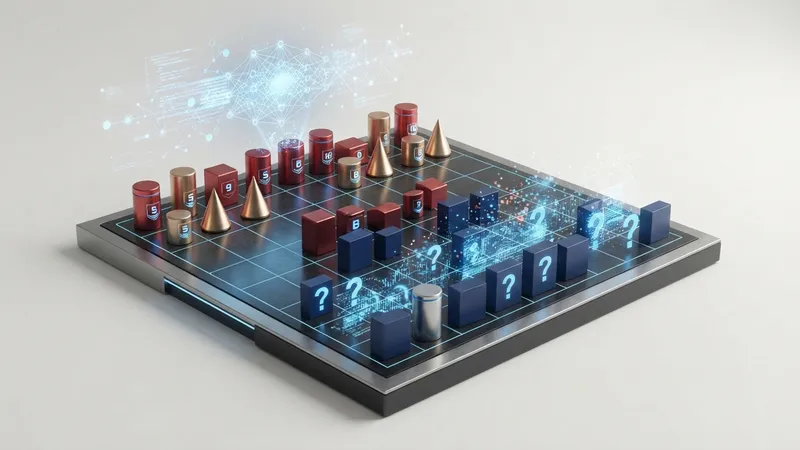
《战棋》之所以如此艰难,核心在于其巨大的隐藏信息量。游戏中,每位玩家拥有 40 个棋子,代表不同的军衔、炸弹和一面旗帜。胜利目标是夺取对手的旗帜。尽管玩家知道对手棋子的位置,却无法得知其身份,只有在棋子发生碰撞时,身份才会揭示。这种不完全信息博弈的特性与扑克类似,但复杂度远超。麻省理工学院计算机科学家、论文合著者 Gabriele Farina 指出,德州扑克中只有两张底牌是隐藏的,组合数相对有限(1326 种),而《战棋》中 40 个棋子 的排列组合可达亿亿亿万种(Decillion,即 10^33 级)。
除了庞大的隐藏信息,游戏时长也是一大挑战。Farina 提到,国际象棋通常 40 步 左右结束,而《战棋》一局可轻松达到 2000 步。更重要的是,它涉及到“虚张声势”(bluffing)的博弈策略。玩家有时会移动一个弱棋子,伪装成元帅来威慑对手。如何在虚张声势与可预测性之间取得平衡,正是此前AI(如 DeepMind 在 2022 年推出的 DeepNash)难以攻克的症结所在。而 Ataraxos 的成功,无疑为AI在处理复杂不完全信息博弈和长期战略规划方面,带来了新的突破。
Ataraxos 在《战棋》领域的突破,不仅仅是又一个AI征服游戏的里程碑,更是对 AI Agent 生态未来发展的一个极具启发性的信号。该项目成功应对了“海量隐藏信息”和“超长决策链”这两大核心挑战,这在现实世界的 AI Agent 应用中至关重要。传统的强化学习往往在完全信息或有限隐藏信息的环境中表现出色,但在面对像《战棋》这样拥有 10^33 种初始布局、决策周期长达 2000 步 的场景时,会遭遇状态空间爆炸和信用分配难题。 Ataraxos 能够有效处理这些复杂性,并掌握“虚张声势”等高级博弈策略,表明其内部可能融合了更先进的蒙特卡洛树搜索(MCTS)、深度神经网络对不完全信息环境的建模能力,以及某种形式的信念状态跟踪(belief state tracking)。
与 DeepMind 的 DeepNash 相比,尽管两者都旨在解决不完全信息博弈,但 DeepNash 主要聚焦于像无限制德州扑克这类信息更新相对频繁、短期决策影响大的游戏,且其训练成本巨大。 Ataraxos 在《战棋》中展现出的高效泛化能力和显著的资源节约(仅 16 块 GPU),预示着未来 AI Agent 的开发可能不再完全依赖于极致的算力堆砌,而更注重算法的精巧设计与对复杂博弈理论的深度融合。这对于构建在动态、高不确定性环境中自主决策、并需要与人类或其他AI进行策略交互的 AI Agent 具有深远影响。例如,在自动驾驶的交通博弈、多智能体协同作战、金融市场预测及智能供应链管理等领域,需要Agent能够理解并预测他者意图、进行长期规划,甚至在必要时采取欺诈或误导性策略。 Ataraxos 的成功,为这些“智能体”在更接近真实世界的复杂博弈中实现“超人”表现,提供了宝贵的经验与技术路线。