在人工智能的黄金时代,硅谷正沉浸在一种被统称为“AI无限丰饶”(AI Abundance)的宏大叙事中。支持者认为,随着模型规模的指数级增长,认知与算力将变得像空气一样廉价且无穷无尽。然而,现实的物理墙正在快速逼近,打破了这一美好的幻觉。从电网容量不足到高质量训练数据的枯竭,AI的物理局限性正变得愈发显著。
首先,能源瓶颈已成为制约大模型发展的最大阻碍。据估计,运行一个先进的 AI 集群需要消耗数吉瓦(GW)的电力。不仅是微软、谷歌等巨头在抢购核电,英伟达(NVIDIA)的最新芯片也面临着巨大的供电压力。其次,“数据荒”(Data Wall)正在显现。研究表明,互联网上公开的高质量人类文本数据可能在未来几年内被消耗殆尽。即便采用合成数据,也面临着模型崩溃(Model Collapse)的系统性风险。
此外,极高的资本支出(CapEx)与低回报率(ROI)之间的矛盾开始加剧。华尔街对科技巨头数千亿美元的 AI 基础设施投入已产生动摇。这迫使行业重新思考:我们是否真的需要万亿参数的通用模型来解决所有问题?在这一背景下,基于特定任务、运行在端侧或边缘侧的轻量化 AI Agent开始受到追捧。
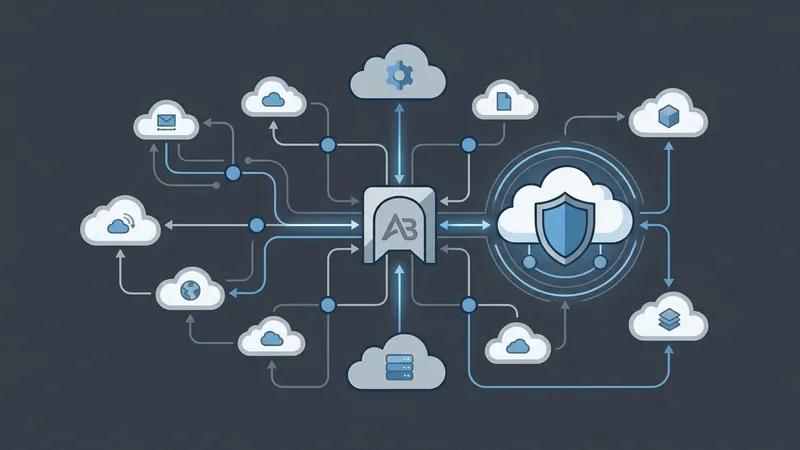
所谓“AI丰饶幻觉”的破灭,实际上是 AI Agent 生态走向成熟的催化剂。过去,行业盲目追求“暴力美学”,寄希望于通过无限做大底层大模型(LLM)来解决一切。但在算力和能源的双重约束下,这种中心化的“超级大脑”路径显然无法支撑大规模商业落地。未来的 AI Agent 生态必将朝着混合架构(Hybrid Architecture)演进。通过引入类似MCP(模型上下文协议)的标准化接口,Agent 可以根据任务复杂度,智能地在本地小模型与云端大模型之间进行动态路由。这种“小脑负责执行、大脑负责规划”的分层设计,不仅能大幅降低高达 80% 的运行成本,更能在不依赖“无限算力”的前提下,实现 AI 生产力的真正爆发。这也将推动 Agent 框架(如 #LangChain、#CrewAI)从简单的提示词编排向更高效的资源调度系统演进。