混合专家(MoE)架构已成为大模型扩展的主流方案,但不同模型在路由机制上的设计差异巨大,直接影响推理效率、训练稳定性和最终效果。本文对比DeepSeek、Qwen、Mixtral、Llama 4和gpt-oss的路由策略,帮助开发者理解各自优劣。
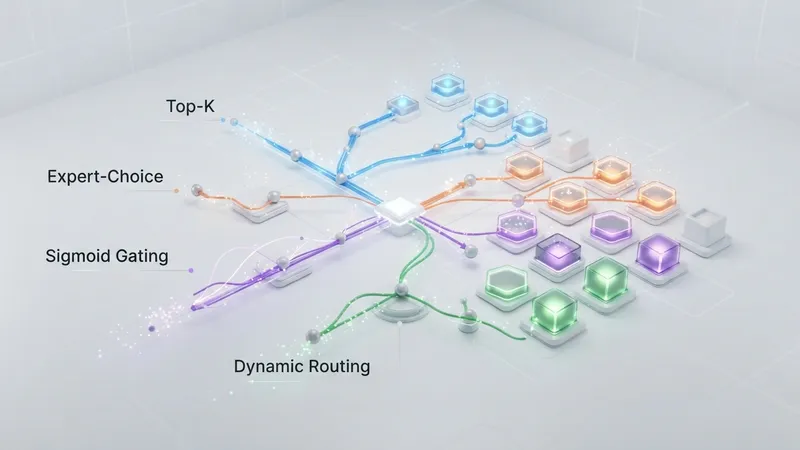
DeepSeek采用细粒度专家分割和共享专家设计,路由时每个token激活少量专家,并通过辅助损失实现负载均衡。其DeepSeek-V3使用sigmoid门控而非softmax,提升了训练稳定性。这种设计在保持高性能的同时显著降低计算量。
Qwen系列(如Qwen1.5-MoE)采用top-k路由,每个token选择固定数量的专家,并引入共享专家以捕获通用知识。其路由网络经过精心初始化,避免专家崩溃。#Qwen还通过容量因子控制每个专家的负载,平衡效率与质量。
Mixtral(Mistral AI)是早期开源MoE的代表,使用top-2路由,每个token激活两个专家。其路由简单高效,但缺乏共享专家机制,可能导致参数冗余。#Mixtral 8x7B在推理时仅激活13B参数,展示了MoE的性价比优势。
Llama 4据传将采用更先进的路由策略,可能结合top-k与专家选择机制,并优化负载均衡损失。虽然细节未公开,但Meta的研究方向指向动态路由和专家专业化,以提升多任务表现。
gpt-oss作为OpenAI开源的MoE模型,路由设计强调可解释性和稳定性。其采用基于sigmoid的门控和辅助负载均衡损失,并可能引入专家容量限制,防止过载。gpt-oss的路由策略在开源社区引发广泛讨论,因其平衡了性能与部署成本。
总体来看,MoE路由的核心挑战在于负载均衡与专家专业化之间的权衡。#DeepSeek和Qwen通过共享专家和细粒度设计提升效率,Mixtral以简单top-k取胜,Llama 4和gpt-oss则探索更动态的方案。对于AI Agent开发者,选择路由策略需考虑任务多样性、推理延迟和硬件约束。
MoE路由机制的差异不仅是技术细节,更决定了AI Agent生态的底层效率。DeepSeek的细粒度共享专家设计显著降低了激活参数,使Agent在复杂任务中能快速响应;Qwen的top-k路由则通过容量因子平衡负载,适合多轮对话场景。相比之下,Mixtral的简单top-2路由虽高效,但缺乏共享专家可能导致通用知识重复存储,增加Agent的认知负担。Llama 4和gpt-oss的动态路由探索预示着未来Agent将能根据任务类型自适应选择专家,实现真正的“按需计算”。长远来看,路由策略的优化将推动Agent从单一任务向多任务协同进化,降低部署成本的同时提升推理质量。开发者应关注路由与Agent工作流的耦合,例如在工具调用场景中,路由的负载均衡能力直接影响并发处理能力。未来,我们可能看到路由机制与强化学习结合,让Agent在运行中动态调整专家激活模式,这将是AI Agent生态的重要突破点。