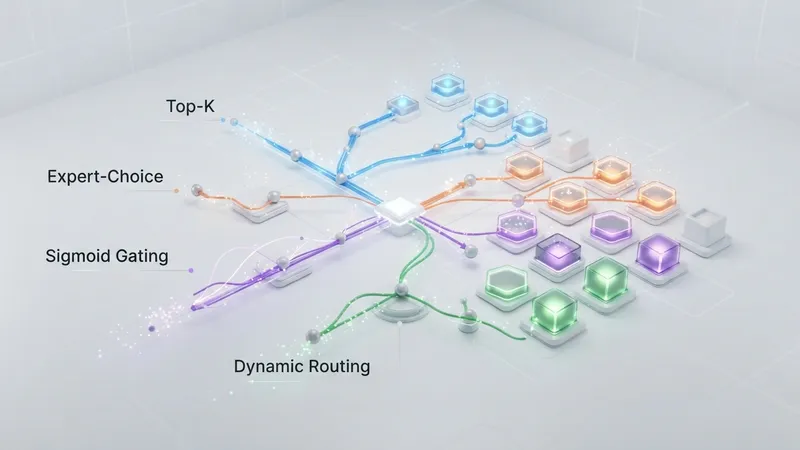
混合专家(#MoE)架构已成为现代大语言模型扩展的核心范式,而路由策略则是决定MoE性能的关键。本文深入解析2026年主流的四种路由方案:Top-K路由、专家选择路由、Sigmoid门控与动态路由。
Top-K路由是最经典的方案,每个token由门控网络计算所有专家的得分,选择得分最高的K个专家激活。其优势在于实现简单、计算高效,但容易导致负载不均衡——少数专家被过度使用,多数专家闲置。典型代表如Switch Transformer采用Top-1路由,GShard采用Top-2路由。
专家选择路由反转了选择逻辑:由专家选择token而非token选择专家。每个专家根据容量限制选择得分最高的token。这种方法天然保证负载均衡,但需要额外的token分配算法,且可能牺牲部分模型质量。代表工作包括Expert Choice Routing。
Sigmoid门控用独立的sigmoid函数替代softmax,每个专家独立判断是否激活,避免了softmax的竞争性归一化。这提升了路由的灵活性,但需要更精细的辅助损失来防止专家崩溃。代表模型如DeepSeek-V3采用sigmoid门控配合无辅助损失的负载均衡策略。
动态路由则根据输入自适应调整路由深度或专家数量,而非固定K值。这能显著提升计算效率,但增加了训练复杂度。2026年的新趋势是将动态路由与专家选择结合,实现更细粒度的计算分配。
选择路由策略需权衡负载均衡、训练稳定性、推理效率和模型质量。对于大规模AI Agent部署,Sigmoid门控配合动态路由正成为主流选择。
MoE路由策略的演进对AI Agent生态具有深远影响。#Top-K路由的负载不均衡问题在Agent多任务场景下会被放大——不同任务对专家需求差异巨大,静态K值难以适配。专家选择路由虽保证均衡,但token分配算法在Agent长上下文场景中可能引入额外延迟。Sigmoid门控的独立激活机制更契合Agent的稀疏激活需求,DeepSeek-V3的实践证明了其可行性。动态路由则代表未来方向:Agent任务复杂度动态变化,固定路由深度是浪费。横向对比来看,Mixtral的Top-2路由适合通用场景,而Agent场景更需要动态路由的弹性。未来,路由策略将与Agent编排深度耦合——路由层可能直接感知任务类型和上下文长度,实现专家激活的预测性调度。这对Agent生态意味着更低的推理成本和更高的任务适应性,但也对训练稳定性提出更高要求。2026年,我们预计看到更多Agent专用MoE架构,路由策略成为差异化竞争的关键。