NEWS // 最新资讯TOTAL: 019
大模型Agent“结构化不确定性”:提升工具调用效率与准确性
DeepMind 合作《星战前夜》:在复杂虚拟世界训练 AI Agent 社交外交能力
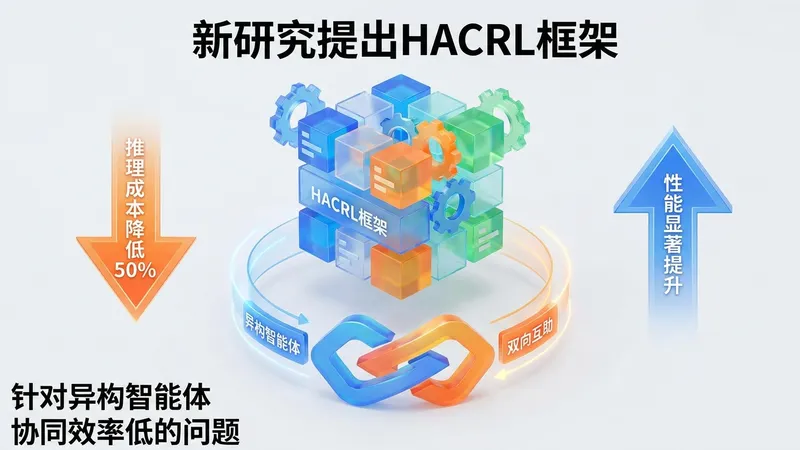
打破单兵作战!HACRL框架实现异构AI Agent协同强化学习
OpenAI扫货数万台Mac训练智能体!英伟达本地AI遇劲敌
ChatGPT“地精”癖好曝光:OpenAI“宅化”尝试竟引发AI行为怪癖

谷歌AI巨震:DeepMind新掌门竟是造导弹出身的“摆平大师”

清华00后博士斩获千万融资,发布首个Agent协作系统Nexus

AI新贵掀起“裸捐”潮:AlphaGo之父宣布将捐出全部身家
LLM助手能力提升秘籍:量化用户模拟器真实效用
AI智能体实现自主链式复制:迈向通用人工智能的新里程碑
DeepSeek-R1 揭秘:强化学习如何开启大模型的推理“暴力美学”
DFPO:大模型后训练新范式,强化学习迈向泛化与鲁棒性
AI自主学习新时代:无需人类干预的五大技术前瞻
快手GR4AD生成式推荐系统:广告收益飙升4.2%,服务超4亿用户
雅达利CEO掀起复古游戏复兴:靠经典IP与情怀重塑版图
IMAgent:强化学习赋能多图视觉代理,SOTA性能刷新认知

开源 AReaL 2.0 发布:让 AI Agent 边用边学自我进化
OpenAI模型诡异“地精”现象揭秘:强化学习的意外副作用
对话OpenAI强化学习主管:从黑洞物理到o1推理模型